在 Node.js 或 Electron 使用 PaddleOCR
PaddleOCR 是百度开源的一个 OCR 识别库,在开源的 OCR 识别库里,PaddleOCR 的中文识别准确率算是比较高的,远高于 Tesseract-OCR。
如果你不想用在线的 OCR 服务,PaddleOCR 是一个比较好的选择。
原版的 PaddleOCR 使用 Python 开发,现在模型已经被移植到了多个平台,可以运行在 C++/Java,也可以运行在 Android 平台,甚至可以运行在浏览器端。
我自用的 Electron OCR 程序也包含 PaddleOCR,可以查看 https://github.com/changbin1997/OCRanslate 。
下面简单写一下我的使用方式和可能遇到的问题,如果你要在 Node.js 使用 PaddleOCR 也可以简单参考一下,如果你用 AI 开发,也可以把这篇文章扔给 AI 参考。
安装所需模块
Node.js 中也有第三方封装的 PaddleOCR 库,我使用的 ppu-paddle-ocr 是维护比较活跃的一个。它使用 TypeScript 开发,把 PaddleOCR 的 PP-OCR 系列模型转换成了 ONNX 格式,通过 ONNX Runtime 来运行,所以不需要安装 Python 和 PaddlePaddle,只需要安装几个 npm 模块就能在 Node.js 中完成 OCR 识别。
ppu-paddle-ocr 不止支持 Node.js,还支持 Bun、Deno、浏览器、浏览器扩展和 React Native,同一个包、同一个 API,在 Node.js 中使用只需要再配合 onnxruntime-node 运行环境。
初始化项目:
npm init -y使用 npm 安装所需模块:
npm install ppu-paddle-ocr onnxruntime-node --saveonnxruntime-node 是 ONNX Runtime 的 Node.js 绑定,它是 ppu-paddle-ocr 的可选依赖,需要手动安装。onnxruntime-node 包含原生二进制文件,安装包会比较大(大约 200 多 MB),安装需要多等一会。
ppu-paddle-ocr 内部会使用全局 fetch 和 AbortSignal.timeout,这两个 API 是 Node.js 18 才引入的,所以推荐使用 Node.js 18 或更高版本。如果使用 Node.js 16 之类的旧版本,需要先加载一个兼容层,后面会介绍。
下载模型
ppu-paddle-ocr 使用 PP-OCR 系列模型,一个完整的识别模型包含三个文件:
- 检测模型:检测图片中的文字位置
- 识别模型:识别文字的具体内容
- 字符字典:识别结果解码时需要用到的字典文件
默认使用的是 PP-OCRv6 tiny 模型,这个模型支持中英文等 50 多种语言。如果初始化的时候不指定模型,第一次运行时会自动从 HuggingFace 下载默认模型,下载后缓存到用户目录的 .cache\ppu-paddle-ocr 目录(Windows 系统是 C:\Users\你的用户名\.cache\ppu-paddle-ocr),之后运行就会直接使用缓存,不需要重复下载。
自动下载依赖网络,而且模型缓存在系统用户目录里,不太容易管理。如果你想使用项目目录下的本地模型,可以手动下载下面三个文件,放到项目的 models 目录:
| 组件 | 文件名 | 下载地址 |
|---|---|---|
| 检测模型 | PP-OCRv6_tiny_det.ort | https://huggingface.co/snowfluke/ppu-paddle-ocr-models/resolve/main/detection/ort/PP-OCRv6_tiny_det.ort |
| 识别模型 | PP-OCRv6_tiny_rec.ort | https://huggingface.co/snowfluke/ppu-paddle-ocr-models/resolve/main/recognition/ort/PP-OCRv6_tiny_rec.ort |
| 字符字典 | ppocrv6_tiny_dict.txt | https://huggingface.co/snowfluke/ppu-paddle-ocr-models/resolve/main/recognition/ppocrv6_tiny_dict.txt |
识别图片
下面使用项目目录 models 下的本地模型识别一张图片:
import { PaddleOcrService } from "ppu-paddle-ocr";
import fs from "node:fs";
import path from "node:path";
import { fileURLToPath } from "node:url";

// 获取当前文件所在目录(ESM 模块中没有 __dirname)
const __dirname = path.dirname(fileURLToPath(import.meta.url));
const IMAGE_PATH = path.join(__dirname, "img.png");  // 要识别的图片
const MODEL_DIR = path.join(__dirname, "models");  // 模型目录

// 初始化 PaddleOcrService,指定本地模型文件
const service = new PaddleOcrService({
  model: {
    detection: path.join(MODEL_DIR, "PP-OCRv6_tiny_det.ort"),
    recognition: path.join(MODEL_DIR, "PP-OCRv6_tiny_rec.ort"),
    charactersDictionary: path.join(MODEL_DIR, "ppocrv6_tiny_dict.txt"),
  },
});

// 加载模型,初始化服务
await service.initialize();

// 读取图片
const imageBuffer = fs.readFileSync(IMAGE_PATH);
// 转换为 ArrayBuffer
const imageArrayBuffer = imageBuffer.buffer.slice(
  imageBuffer.byteOffset,
  imageBuffer.byteOffset + imageBuffer.byteLength
);

// 识别图片
const result = await service.recognize(imageArrayBuffer);
console.log(result.text);

// 销毁服务,释放模型
await service.destroy();
ppu-paddle-ocr 是纯 ESM 模块,只能使用 import 引入,项目的 package.json 中需要设置 "type": "module" 才能直接运行。
PaddleOcrService 初始化时需要传入一个配置对象,model 里的三项就是三个模型文件的路径,detection 是检测模型,recognition 是识别模型,charactersDictionary 是字符字典。
初始化完成后就可以调用 recognize 识别图片了,recognize 的图片参数可以是 ArrayBuffer,也可以直接传图片路径字符串,例如:
const result = await service.recognize(path.join(__dirname, "img.png"));直接传路径就不需要 fs.readFileSync 读取图片了。
在我的电脑上,模型加载大约需要 2 秒,识别一张 8KB 左右的图片大约需要 0.6 秒,识别结果如下:
点击查看折叠内容
这就是被折叠的内容。
原图:
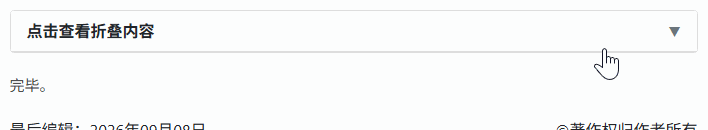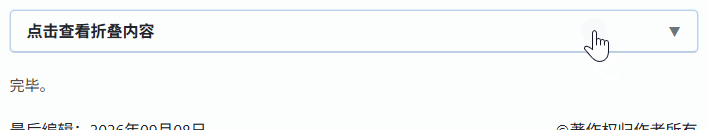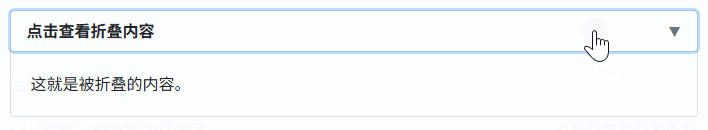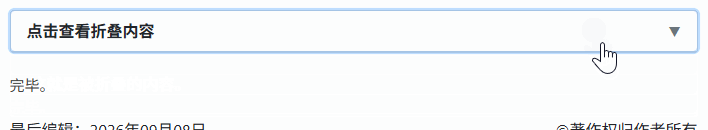
我识别的是静态的 png 图片,这种比较简单的截图,基本不会出错。
识别结果
recognize 返回的结果包含以下属性:
text:识别出的完整文本,每一行以换行符分隔lines:按行分组的识别结果,是一个二维数组,每一项代表一行,每一行包含多个识别结果confidence:平均置信度,范围是 0~1,值越大识别越可靠
lines 中每个识别结果都包含 text(识别文字)、box(文字区域坐标)、confidence(置信度)三个属性,其中 box 包含 x、y、width、height 四个值,也就是文字区域的左上角坐标和宽高。
下面按行输出识别结果,并计算每一行的平均置信度:
result.lines.forEach((line, index) => {
  // 拼接这一行的文字
  const lineText = line.map((item) => item.text).join(" ");
  // 计算这一行的平均置信度
  const avg = line.reduce((sum, item) => sum + item.confidence, 0) / line.length;
  console.log(`[行 ${index + 1}] ${lineText} (置信度 ${(avg * 100).toFixed(1)}%)`);
});
输出结果如下:
[行 1] 点击查看折叠内容  (置信度 99.9%)
[行 2] 这就是被折叠的内容。 (置信度 100.0%)
使用默认模型
如果不想手动下载模型,也可以不指定 model,直接使用默认的 PP-OCRv6 tiny 模型,第一次运行时会自动下载:
import { PaddleOcrService } from "ppu-paddle-ocr";

const service = new PaddleOcrService();
await service.initialize();

const result = await service.recognize("./img.png");
console.log(result.text);

await service.destroy();
ppu-paddle-ocr 还提供了一些预设模型,通过导入预设常量可以直接切换模型:
import { PaddleOcrService, V6_SMALL_MODEL } from "ppu-paddle-ocr";

// 使用 PP-OCRv6 small 模型(完整字典,适合密集文档)
const service = new PaddleOcrService({ model: V6_SMALL_MODEL });
await service.initialize();
下面是一些常用的预设模型:
| 预设常量 | 说明 |
|---|---|
V6_TINY_MODEL | PP-OCRv6 tiny,默认模型,速度最快 |
V6_SMALL_MODEL | PP-OCRv6 small,完整字典,适合密集文档 |
V6_MEDIUM_MODEL | PP-OCRv6 medium,服务级模型,精度最高,速度最慢 |
V5_MOBILE_MODEL | PP-OCRv5 移动端模型,中英文 |
V5_SERVER_MODEL | PP-OCRv5 服务端模型,精度更高 |
V5_EN_MOBILE_MODEL | PP-OCRv5 英文移动端模型,只支持英文 |
V6 系列都是多语言模型,一个模型可以识别中英文等 50 多种语言。V5 系列大多是单语言模型,每种语言一个模型,如果图片的语言是固定的,选择对应的 V5 模型可以避免跨语言干扰,准确率会更高一些。
如果只需要识别一张图片,也可以直接使用 ocr 函数,它会自动完成服务的创建和销毁,不需要手动管理:
import { ocr } from "ppu-paddle-ocr";

const result = await ocr("./img.png");
console.log(result.text);
需要处理多张图片时还是建议使用 PaddleOcrService,模型只需要初始化一次,之后的识别都可以复用,速度会快很多。
批量识别
PaddleOcrService 提供了 batchRecognize 方法,可以批量识别多张图片,返回的结果和传入的图片顺序一致:
const results = await service.batchRecognize([
  "./img1.png",
  "./img2.png",
  "./img3.png",
]);

results.forEach((result, index) => {
  console.log(`图片 ${index + 1}: ${result.text}`);
});
batchRecognize 会限制同时处理的图片数量,避免同时加载太多图片导致内存占用过高,默认在 CPU 上最多同时处理 4 张图片。可以通过 concurrency 选项调整:
const results = await service.batchRecognize(images, {
  concurrency: 8,  // 同时处理 8 张图片
});
如果某张图片识别失败,默认整个批次都会中断。设置 settle: true 后,失败的图片会返回 {status: "rejected", reason},不会中断后面的图片。
只检测文字位置
如果不需要识别文字内容,只想获取图片中文字的位置,可以使用 detect 方法,它只运行检测模型,返回所有文字区域的坐标:
const { boxes } = await service.detect("./img.png");
// boxes 是一个数组,每个元素包含 x、y、width、height
console.log(boxes);
输出类似下面这样:
[
  { x: 82, y: 68, width: 96, height: 24 },
  { x: 64, y: 108, width: 112, height: 24 }
]
detect 还可以通过 crop: true 把每个文字区域裁剪成 PNG 图片返回,或者通过 saveCropsTo 把裁剪的图片直接保存到目录:
// 返回裁剪图片,和 boxes 顺序一致
const { crops } = await service.detect("./img.png", { crop: true });

// 把裁剪的图片保存到 out 目录
await service.detect("./img.png", { saveCropsTo: "./out" });
识别策略
PP-OCR 的识别分为两个阶段:先用检测模型找出文字区域,再把每个文字区域裁剪下来交给识别模型识别。strategy 选项控制检测到的文字区域如何分组识别,支持以下三个值:
per-box:每个检测到的文字区域单独识别,区域隔离最彻底,但推理次数最多per-line:同一行的文字区域合并后一起识别,推理次数少,默认值,准确率也不错cross-line:跨行打包识别,推理次数最少,速度最快,适合文字密集的文档
在初始化服务的时候可以设置识别策略:
const service = new PaddleOcrService({
  recognition: {
    strategy: "per-box",
  },
});
也可以在调用 recognize 的时候单独指定:
const result = await service.recognize("./img.png", {
  strategy: "cross-line",
});
对于普通图片,使用默认的 per-line 就可以了。
Node.js 16 兼容
ppu-paddle-ocr 内部会使用全局 fetch(自动下载模型的时候)和 AbortSignal.timeout,这两个 API 都是 Node.js 18 才引入的。如果你的 Node.js 版本低于 18,直接运行会报错,需要提前加载一个兼容层。
下面是我在 Node.js 16 项目中使用的兼容代码,放在 setup-node16.js 文件里:
import fetch from "node-fetch";

// ppu-paddle-ocr 需要全局 fetch(Node 18+ 才有)
if (typeof globalThis.fetch !== "function") {
  globalThis.fetch = fetch;
}

// 补上 AbortSignal.timeout(Node 18+ 才有)
if (typeof AbortSignal.timeout !== "function") {
  AbortSignal.timeout = (ms) => {
    const controller = new AbortController();
    const timer = setTimeout(() => {
      controller.abort(new Error(`The operation was aborted due to timeout (${ms} ms)`));
    }, ms);
    if (typeof timer.unref === "function") timer.unref();
    return controller.signal;
  };
}
这个兼容层需要安装 node-fetch:
npm install node-fetch --save然后在 index.js 的第一行引入兼容层:
import "./setup-node16.js";如果你的 Node.js 版本是 18 或以上,就不需要这个兼容层。
以上就是在 Node.js 中使用 PaddleOCR 的方法。ppu-paddle-ocr 把 PaddleOCR 的模型转换成了 ONNX 格式,配合 ONNX Runtime 运行,不需要安装 Python 环境,在 Node.js 中就可以完成 OCR 识别。识别使用的是本地模型,图片不会上传到服务器,也没有调用次数限制。
关于 Electron 使用
Electron 还是和 Node 一样的写到主进程里,可以通过文件选择对话框或截图来获取图片识别。
如果你使用 electron-builder 打包,需要注意一下 build.asarUnpack 的配置,可以配置为 node_modules/**,也就是不把用到的 node_modules 模块打包到 app.asar 文件。
使用上面的配置,用到的 node_modules 模块会打包到生成后的程序目录的 resources/app.asar.unpacked/node_modules 目录。
在 Electron 使用也可以参考 https://github.com/changbin1997/OCRanslate 。
版权声明:本文为原创文章,版权归 Changbin's Blog 所有,允许非商业转载,转载请用链接注明出处。
本文地址:https://www.misterma.com/archives/969/
如果对本文有什么问题或疑问都可以在评论区留言,我看到后会尽量解答。